Multifactor authentication
We hebben enkel nog maar over wachtwoorden gesproken in dit hoofdstuk, maar uiteraard zijn er ook andere zaken die je kan gebruiken om je te identificeren. Er zijn verschillende factoren die kunnen gebruikt worden om te controleren of een persoon wel degelijk toegang mag krijgen tot een systeem:
- Iets wat je weet: je wachtwoord, je pincode, je rijksregisternummer, etc.
- Iets wat je bent: een eigenschap die uniek is per persoon en onder de noemer “biometrics” valt, zoals je vingerafdruk, irisscan, etc.
- Iets wat je hebt: een stuk hardware zoals een smartphone, USBkey, etc.
- Waar of wanneer je bent: je IP-adres , het moment van de dag dat je probeert in te loggen.
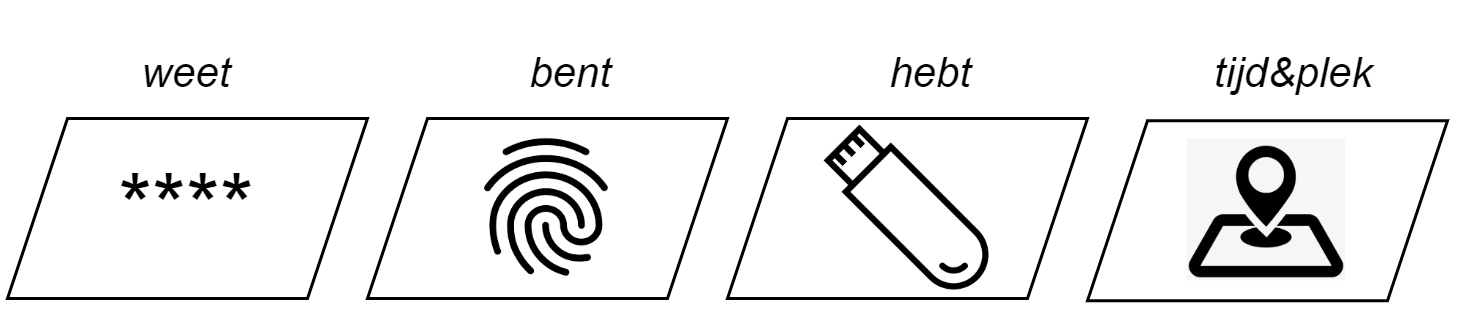
We zien meer en meer systemen verschijnen die aan zogenaamde multifactor authentication (MFA) doen waarbij het systeem minstens twee factoren (2FA) wil controleren voor je toegelaten wordt. Hoe meer verschillende factoren er worden gebruikt bij de authenticatie hoe veiliger het systeem is, maar ook hoe minder gebruiksvriendelijk het wordt. Het blijft dus een afweging tussen die twee eigenschappen om in te schatten wat de ideale hoeveelheid veiligheid en gebruiksvriendelijkheid is die je wenst te hebben.
Systemen die MFA aanbieden doen dit vaak op een gecontroleerde manier: afhankelijk van de gebeurtenissen zal het systeem beslissen of meerdere factoren moeten getest worden of niet. Als je bijvoorbeeld in België woont, maar Google ziet plots dat iemand met jouw wachtwoord probeert in te loggen vanuit een IP-adres op de Azoren, dan zal Google beslissen dat “iets wat je weet” (het wachtwoord) niet genoeg controle is en extra informatie vragen (andere factoren controleren).
Iets wat je weet: Paswoorden
Deze factor hebben we reeds uitvoerig behandeld. Het grote probleem met dingen weten is dat:
- Je ze kan vergeten en daardoor niet meer kan inloggen.
- Anderen die informatie kunnen te weten komen en zich vervolgens als jou voordoen.
Kortom, alhoewel deze factor vaak vanuit technologisch standpunt het eenvoudigst te implementeren is, is het ook de minst veilige vanuit een social engineering standpunt. Biometrics en hardware zijn moeilijker door een digitale stroper te stelen dan het wachtwoord en we hoeven niet bij een fingerprint te vrezen dat de gebruiker een “zwakke vingerafdruk” kiest, iets wat bij wachtwoorden vaak hét primaire probleem is.
Iets wat je bent: Biometrics
“We zijn allemaal uniek”. Iedere mens heeft een hele hoop eigenschappen die uniek zijn per persoon. Zelfs als bepaalde van onze eigenschappen gelijkaardig zijn met andere personen dan zal zeker een combinatie van twee of meerdere eigenschappen dat niet zijn. Door dus menselijke eigenschappen van je te gebruiken als authenticatie hebben we een factor gevonden die zeer moeilijk na te bootsen valt: op voorwaarde dat je een echt unieke eigenschap kiest én deze op deze juiste manier meet.
Enkel veel gebruikte biometrieken als authenticatievorm zijn:
- Vingerafdruk.
- Iris.
- Stem.
- Gezicht (vaak met behulp van “stereo camera” voor 3D beeld).
Maar ook andere metrieken kunnen erg interessant zijn zoals de manier waarop je je wachtwoord invoert, de manier waarop je wandelt (gait) etc.
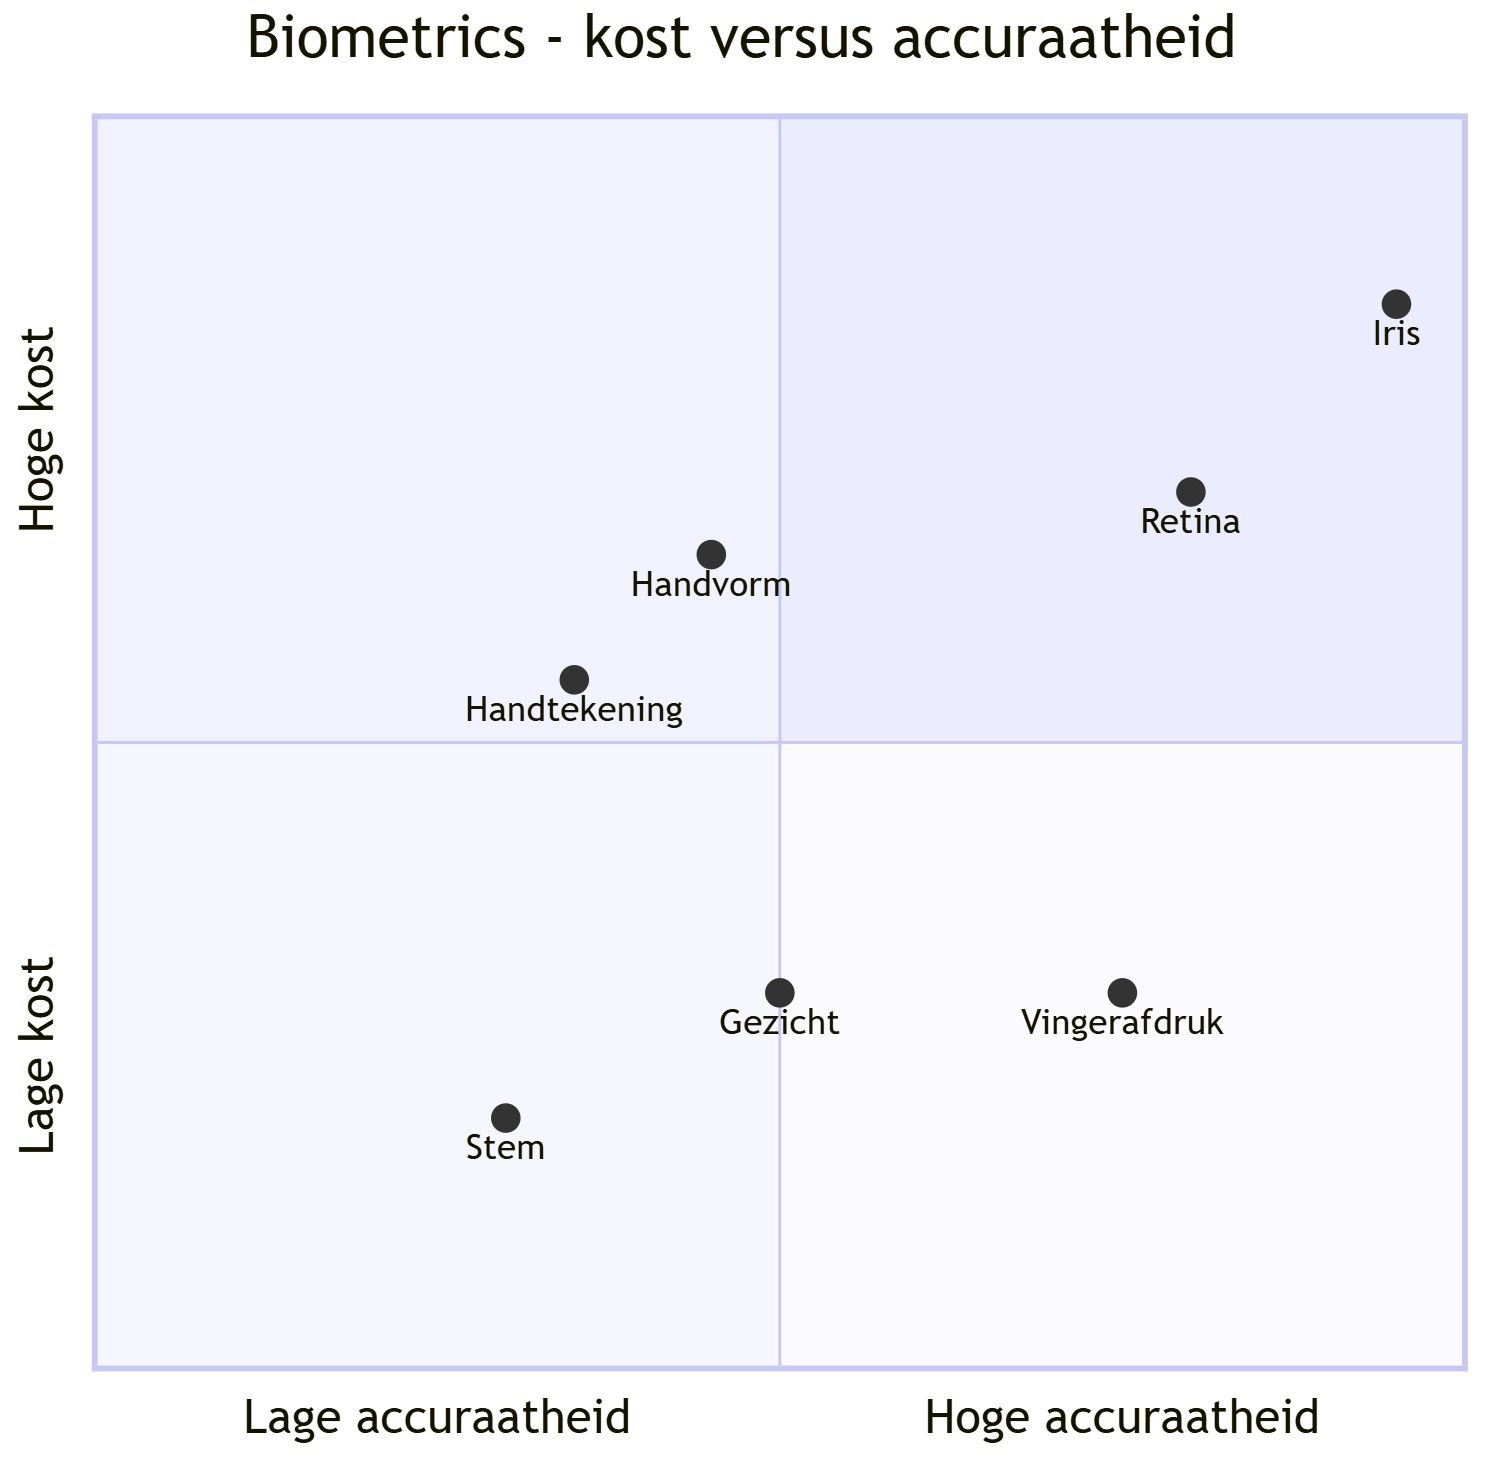
Niet elke biometriek is evenwaardig wat betreft accuraatheid en kost. Iris-scans staan bovenaan qua accuraatheid maar vereisen dure, gespecialiseerde hardware. Retina- en vingerafdruk-scanners zijn redelijk accuraat aan een midden- tot lage kost. Aan de goedkope (maar ook minder accurate) kant vind je bijvoorbeeld stemherkenning en gezichtsherkenning via een gewone webcam. Je keuze van biometriek hangt dus niet alleen af van technische vereisten, maar ook van budget en use case (een irisscan aan de grens is iets heel anders dan gezichtsherkenning om je telefoon te ontgrendelen).
Paswoorden van miljoenen mensen opslaan is één ding. De biometrische gegevens is een heel ander verhaal waarbij ook privacy plots een erg heikel punt wordt (beeld je even in dat Hitler en zijn trawanten 80 jaar geleden toegang hadden tot biometrische data waarmee met een bepaalde zekerheid kon vastgesteld worden of iemand van Joodse origine was of niet.)
In India is de Aadhaar (Indiaas voor “basis”), hun rijksregisternummer zeg maar, een unieke code die gebaseerd is op onder andere de irisscan en vingerafdrukken (alle 10!) van de burger. Deze gigantische database werd in 2018 nog gehackt waardoor mogelijk de informatie van 1.1 miljard geregistreerde burgers werd gestolen.
Om een biometriek in de wachtwoord database te bewaren hebben we een manier nodig om deze te digitaliseren op een zodanige manier dat de unieke aspecten ervan bewaard worden. Voorts moet er rekening mee gehouden worden dat het “registreren” van een biometrische eigenschap nooit 100% accuraat kan. Denk maar aan een tijdelijk krasje op je vinger, je baard die anders geschoren is, etc.
De zogenaamde feature points van een biometrische eigenschap worden in de database bewaard: dit zijn de unieke waarden waarvan geweten is dat deze per persoon anders zijn. We gaan deze niet per biometrische eigenschap bespreken, het volstaat te begrijpen dat in de gebruikersdatabase meestal een korte sequentie van getallen (of letters, denk maar aan een DNA-sample) wordt bewaard die als het ware jouw unieke wachtwoord voorstelt voor die specifieke biometrische eigenschap van j. Enkel wanneer je bij het opnieuw inloggen (quasi) dezelfde feature points genereert als bij de registratie zal deze factor aanvaard worden als correct.
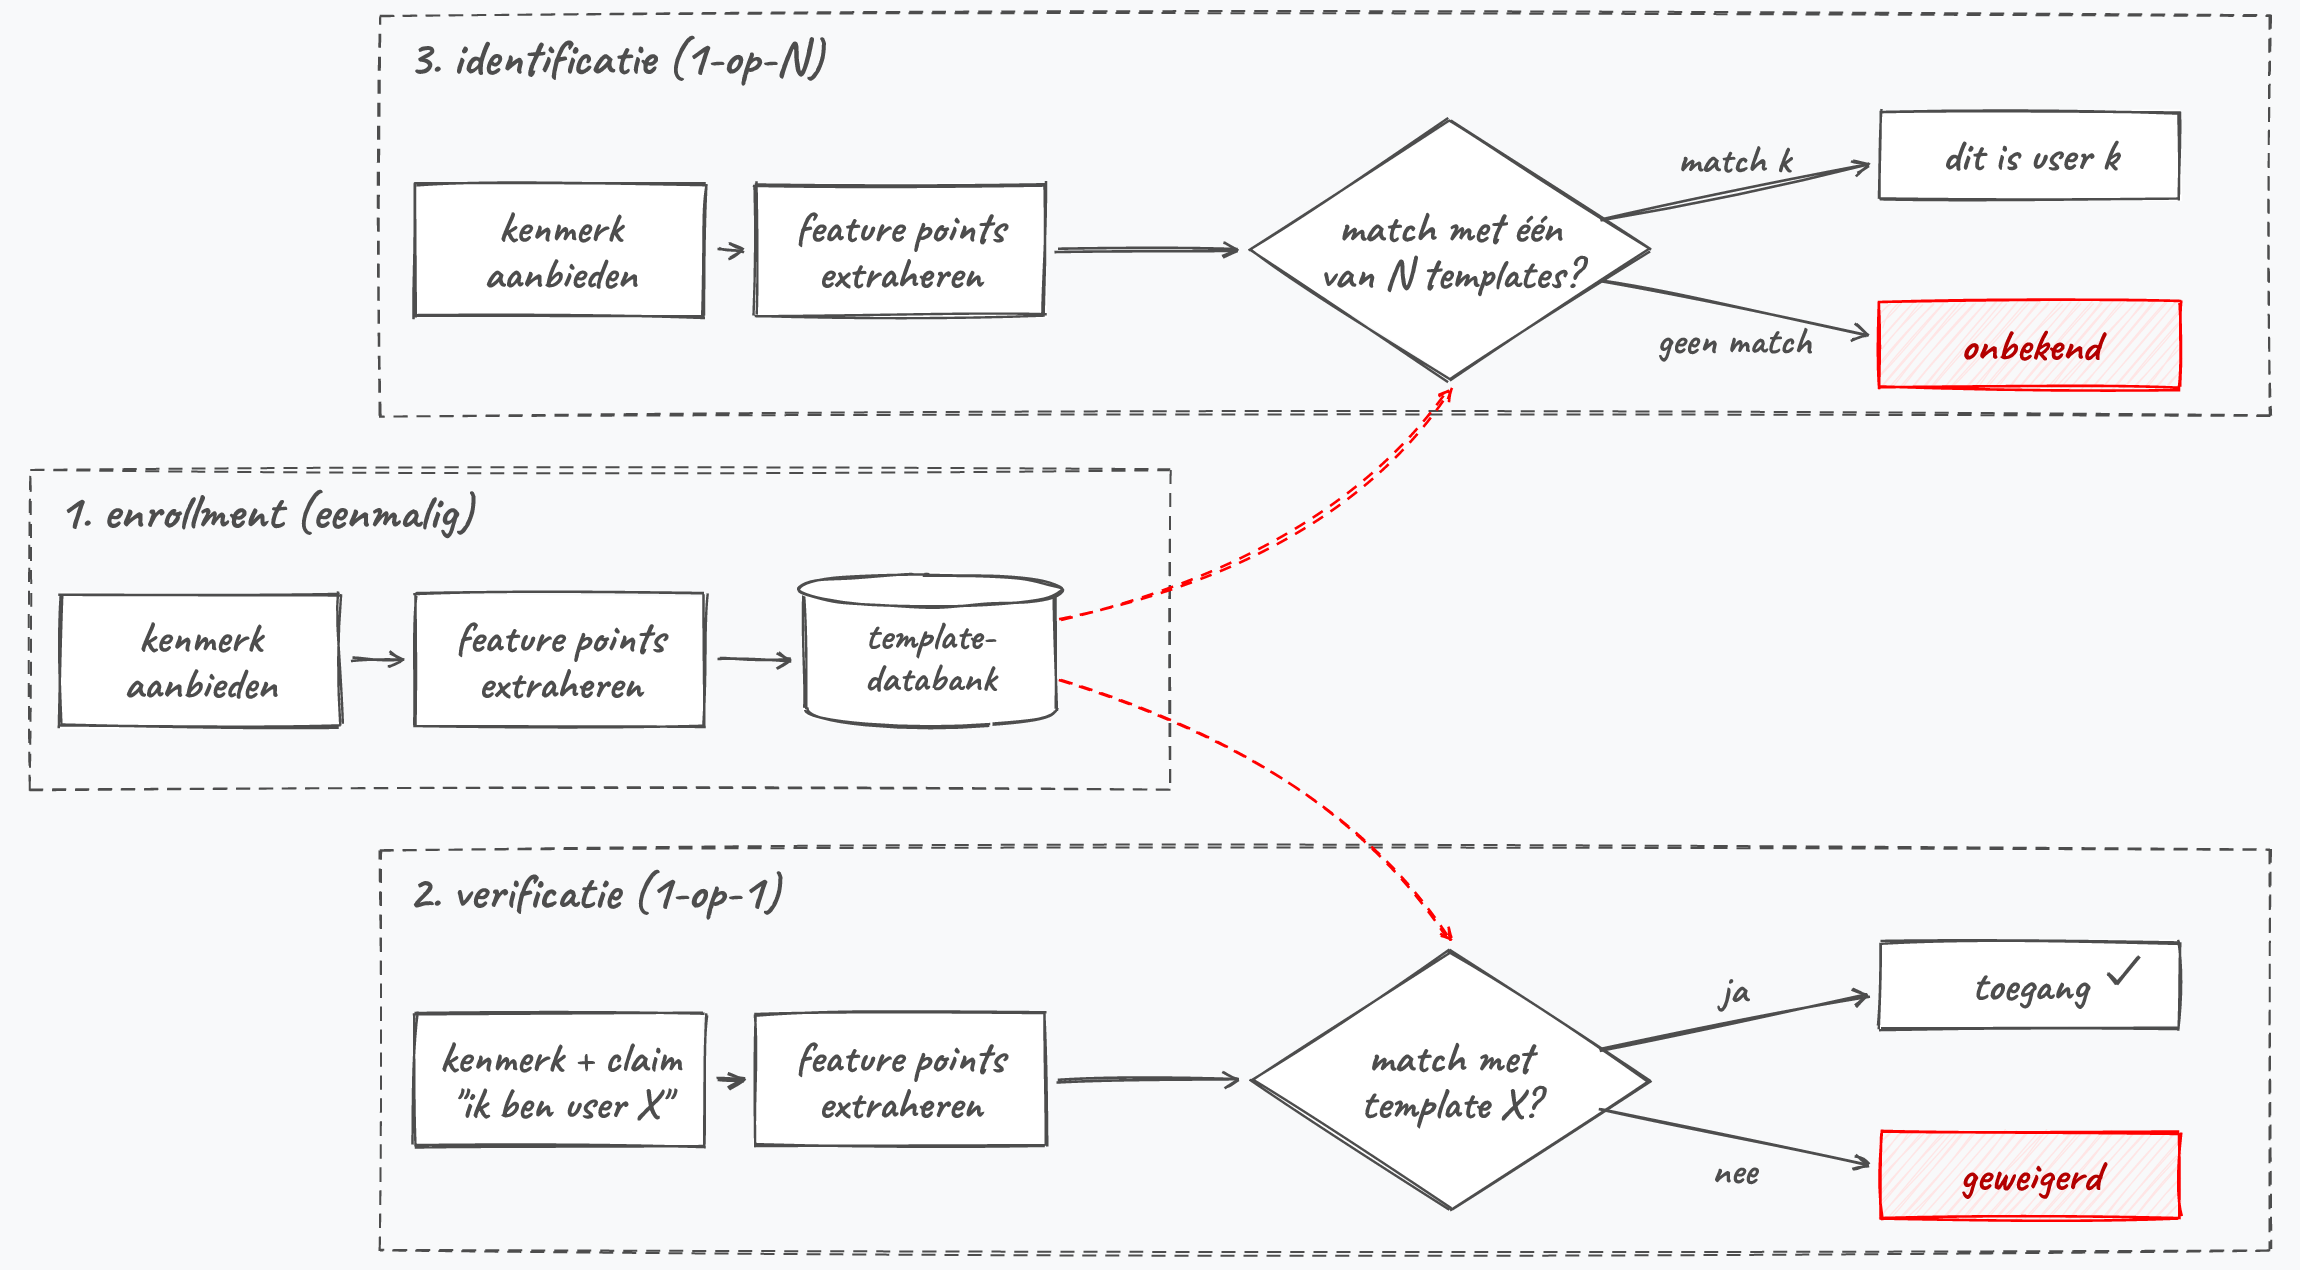
Een biometrisch systeem kent drie duidelijk te onderscheiden fasen:
- Enrollment (registratie): de gebruiker biedt zijn biometrisch kenmerk voor het eerst aan, het systeem extraheert de feature points en bewaart deze in de databank. Dit is het moment waarop de koppeling user ↔︎ biometrie wordt gemaakt.
- Verification (verificatie): “Ben jij wel degelijk user X?” - de aangeboden feature points worden vergeleken met één specifieke template in de databank (1-op-1). Dit is het klassieke inlog-scenario.
- Identification (identificatie): “Wie ben jij?” - de aangeboden feature points worden vergeleken met álle templates in de databank (1-op-N). Dit is een veel zwaardere operatie en wordt typisch ingezet bij bv. grenscontrole of forensisch onderzoek.
Biometrische eigenschappen kunnen niet alleen dienst doen als een extra factor bij het authenticeren, ze zijn uiteraard ook erg handig voor identificatie. In principe kan iemand nog steeds de gebruikersnaam van een ander persoon gebruiken. Als de biometrische eigenschappen als identificatie dienen kunnen aanvallers dat niet meer doen: ze kunnen onmogelijk aan het systeem zeggen “ik ben persoon x” terwijl de vingerafdrukscanner duidelijk een vingerafdruk registreert van persoon y.
Iets wat je hebt: Hardware
Een fysiek object, zeker als het complex is, kan moeilijk nagemaakt worden en is dus een ideale factor. De elektronica van de 21e eeuw behoort tot de meest complexe dingen ooit die de mensheid heeft kunnen vervaardigen. Het is dan ook logisch dat we deze elektronica gebruiken als extra authenticatiefactor. In essentie zal dit stuk hardware nog steeds gewoon een wachtwoord bevatten, maar dit zal echter ongelooflijk veel langer (en dus sterker) zijn dan het gemiddelde wachtwoord dat een standaard gebruiker kan onthouden.
Er zijn twee grote families van hardware-gebaseerde authenticatie-vormen:
- Een smartphone, met daarop een authenticator app.
- Een USB sleutel.
Een nadeel van deze groep is dat het om een fysiek object gaat dat je kan verliezen of dat stuk kan gaan.