Hoe verdedigen
We weten ondertussen wie de stropers zijn, hoe ze te werk gaan en welk gereedschap ze in hun rugzak hebben. Tijd om naar de andere kant van het bos te kijken: wat doet de boswachter eigenlijk de hele dag?
Het eerlijke antwoord is weinig spectaculair. Verdedigen is geen product dat je koopt en installeert, en ook geen eenmalig project dat je op een vrijdagnamiddag afvinkt. Het is dagelijks werk: accounts opkuisen, instellingen nakijken, logs lezen, back-ups testen en afspraken maken voor de dag dat het tóch misloopt. In dit subhoofdstuk bekijken we de principes waarop dat werk steunt, wat je per fase van een aanval kan doen, hoe je een indringer opmerkt en wat je doet als het kalf al half verdronken is.
We blijven hier bewust bij het waarom. Hoe je concreet een firewall, VLAN of logserver instelt, zie je later in de vakken Network Security en Software Security. Hier gaat het erom dat je snapt waarom die maatregelen bestaan, zodat je later niet blind regels overtypt.
De principes
Wat en wie je wilt verdedigen in de cyberwereld kan erg gevarieerd zijn. Toch kunnen we alles herleiden tot 4 + 1 fundamentele principes die je best hanteert indien je een systeem van welke vorm ook wenst te beschermen tegen cyberstropers. Deze zijn:
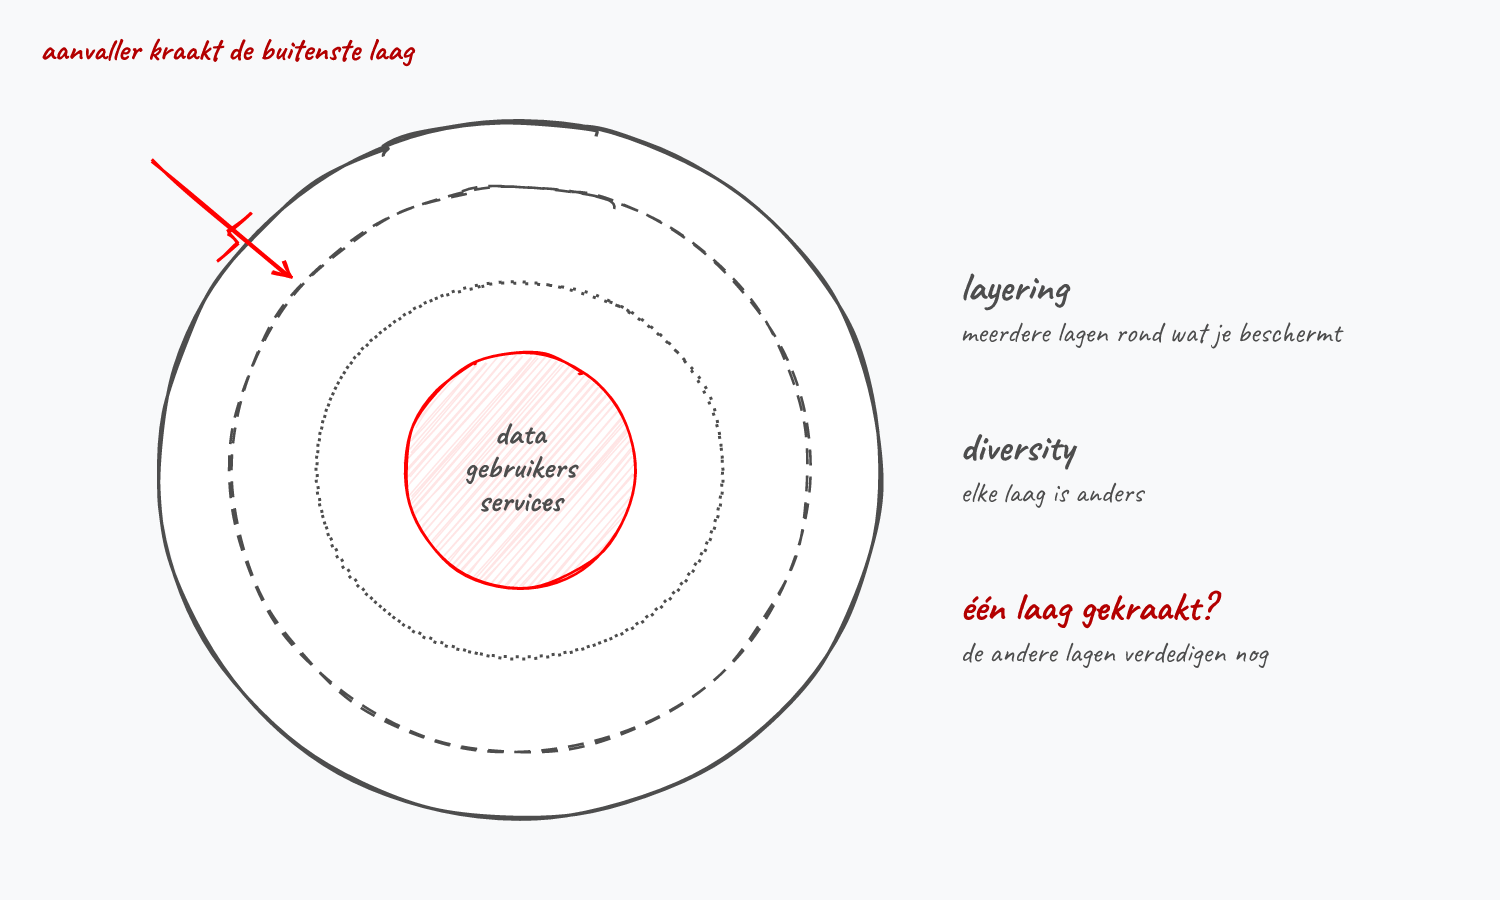
- Layering: bouw je beveiliging zoals de lagen van een ui rondom je te beschermen data, gebruikers en services. Hoe meer lagen hoe beter, op voorwaarde dat ze natuurlijk verschillend zijn. Het voordeel van met meerdere lagen werken is evident: indien één laag om welke reden dan ook gecompromitteerd raakt, zijn er nog steeds de andere lagen die als verdediging werken.
- Limiting: beperk steeds maximaal wat iedereen binnen je systeem kan. Zorg ervoor dat gebruikers en services enkel die zaken kunnen doen waartoe ze recht hebben volgens hun rol. Geef dus niet iedereen admin-rechten, zet je firewall niet op allow all, etc.
- Diversity: zorg ervoor dat je een verscheidenheid aan beveiligingen hebt. Op die manier voorkomen we, net als bij layering, dat het falen van één systeem je hele verdediging neerhaalt.
- Simplicity: KISS, oftewel keep it simple, stupid. Al het voorgaande lijkt te doen uitschijnen dat je complexe systemen moet bouwen die als het ware een doolhof voor de aanvallers maken. Op zich is daar iets van aan, maar zorg er wel voor dat je niet zelf in je doolhof verdwaalt en daardoor fouten introduceert zonder het te beseffen. Soms is less more en dat geldt ook bij beveiliging.
Het vijfde fundamentele principe krijgt een eigen kadertje omdat deze voor discussie vatbaar is én geregeld voor de nodige controverse kan zorgen. Obscurity is nooit een vervanging voor de vier voorgaande principes, enkel een kleine extra bovenop:
- Obscurity: ga niet aan de grote klok hangen hoe jouw verdediging is opgebouwd. Echter, let op met deze leuze. Obscurity wil niet zeggen dat je zelf een of ander vaag crypto-algoritme zelf gaat ontwikkelen en angstvallig gaat geheim houden. Gebruik standaarden en vertrouwde producten in je beveiliging. Eén van de eerste regels in security is “ga niet zelf het wiel heruitvinden”!
Deze principes klinken misschien wat abstract, maar in de praktijk hebben ze allemaal een naam die je in vacatures, audits en beleidsdocumenten zal tegenkomen. Laten we ze eens één voor één vertalen.
Layering en diversity: defense in depth
In de praktijk heet layering defense in depth. Het idee komt uit de militaire wereld: een burcht had niet één muur, maar een gracht, een ophaalbrug, een buitenmuur, een binnenmuur en nog een donjon als laatste toevluchtsoord. Een aanvaller die de gracht overzwemt, staat nog maar aan het begin.
Vertaald naar een bedrijfsnetwerk ziet dat er bijvoorbeeld zo uit: een spamfilter die de meeste phishingmails tegenhoudt, een werknemer die de rest (hopelijk) herkent, MFA die een gestolen wachtwoord waardeloos maakt, een laptop die een verdacht programma blokkeert, en een back-up voor als alles faalt. Geen enkele van die lagen is waterdicht. Samen maken ze het de stroper wel een pak moeilijker, want die moet nu vijf keer na elkaar geluk hebben in plaats van één keer.
Hier komt ook diversity om de hoek kijken. Vijf lagen die allemaal op hetzelfde wachtwoord, dezelfde leverancier of hetzelfde besturingssysteem steunen, zijn in feite maar één laag. Vindt de aanvaller daar een zero day voor, dan vallen ze allemaal tegelijk om.
Limiting: least privilege
Limiting kent iedere systeembeheerder als het principle of least privilege: iedere gebruiker, ieder programma en iedere service krijgt exact de rechten die nodig zijn voor z’n taak, en geen enkel recht meer. De boekhouder moet aan de boekhouding kunnen, maar heeft niets te zoeken op de HR-server. De webserver moet webpagina’s kunnen tonen, maar hoeft geen nieuwe gebruikers te kunnen aanmaken.
Bij gevoelige informatie spreekt men ook van need-to-know: het is niet omdat je een hoge functie of clearance hebt, dat je alles mag inkijken. Je krijgt enkel toegang tot wat je voor je job effectief nodig hebt. Denk terug aan het voorbeeld van het medisch dossier bij CIA: een werknemer die een dossier kan opvragen zonder dat hij er iets mee moet doen, is al een privacyprobleem.
Een erg concrete toepassing: aparte admin-accounts. Een systeembeheerder surft, mailt en opent bijlagen met een gewone account zonder beheerdersrechten. Voor beheertaken logt hij in met een aparte account die enkel daarvoor dient. Klikt hij op een dag op de verkeerde link (en ook systeembeheerders zijn mensen), dan draait de malware met de rechten van een gewone gebruiker in plaats van met de sleutels van het hele domein.
Waarom dit zo belangrijk is, zag je al bij Mimikatz: NotPetya verspreidde zich razendsnel door het netwerk door de hashes en tickets te gebruiken van accounts die op de besmette computers ingelogd waren. Hoe meer rechten die accounts hadden, hoe verder de ransomware kon.
Simplicity: een kleiner aanvalsoppervlak
Iedere dienst die draait, iedere poort die openstaat, iedere account die bestaat en ieder programma dat geïnstalleerd is, is een stukje van je attack surface (het aanvalsoppervlak). Wat er niet is, kan niet aangevallen worden. Simplicity betekent in de praktijk dus vooral: weghalen wat je niet nodig hebt.
Dat proces heet hardening: je neemt een systeem zoals het uit de doos komt en je maakt het zo klein en strikt mogelijk. Typisch komt dat neer op:
- Onnodige services uitzetten: een printer die ook een webserver, een FTP-server en een telnet-dienst draait, terwijl je enkel wilt printen.
- Standaardinstellingen wijzigen: standaardwachtwoorden, standaardaccounts, voorbeeldpagina’s, debugmodi. Aanvallers kennen die defaults beter dan jij. In het hoofdstuk over IoT zie je hoe het Mirai-botnet groot werd op niets anders dan standaardwachtwoorden.
- Ongebruikte accounts verwijderen: denk aan de accounts van ex-werknemers (herinner je de gebroeders Akhter, die meteen na hun ontslag met hun nog actieve credentials 96 databases verwijderden).
Je hoeft niet zelf te bedenken wat “strikt genoeg” is. Organisaties zoals het Center for Internet Security publiceren gratis CIS Benchmarks: uitgebreide checklists per besturingssysteem, browser, database of cloudplatform met aanbevolen instellingen. Zo’n afgesproken set instellingen waar ieder nieuw systeem minstens aan moet voldoen, noemt men een secure baseline.
Het woord “minstens” is hier belangrijk, want een baseline die je één keer instelt, blijft niet vanzelf staan. Iemand zet “even” een poort open om iets te testen, een collega installeert een handige tool, een update zet een oude instelling terug. Na een jaar lijkt je server niet meer op wat je ooit opgezet hebt. Dat heet configuration drift. Daarom werken beheerders steeds vaker met een beschreven desired state: de gewenste configuratie staat in een (script)bestand, en een tool controleert geregeld of het systeem daar nog aan voldoet en zet het desnoods terug. Het grote voordeel: een systeem dat je niet reproduceerbaar kan opbouwen, kan je ook niet betrouwbaar patchen of herstellen. Als niemand nog weet hoe server X ooit geïnstalleerd werd, durft ook niemand er nog een update op te zetten, en na een ransomware-aanval moet je hem uit het niets reconstrueren.
En patchen? Dat is uiteraard ook een vorm van je aanvalsoppervlak klein houden. We gaan het hier niet opnieuw uitleggen: lees het stuk over zero days en patching en het window of vulnerability er nog eens op na.
Verdedigen per fase
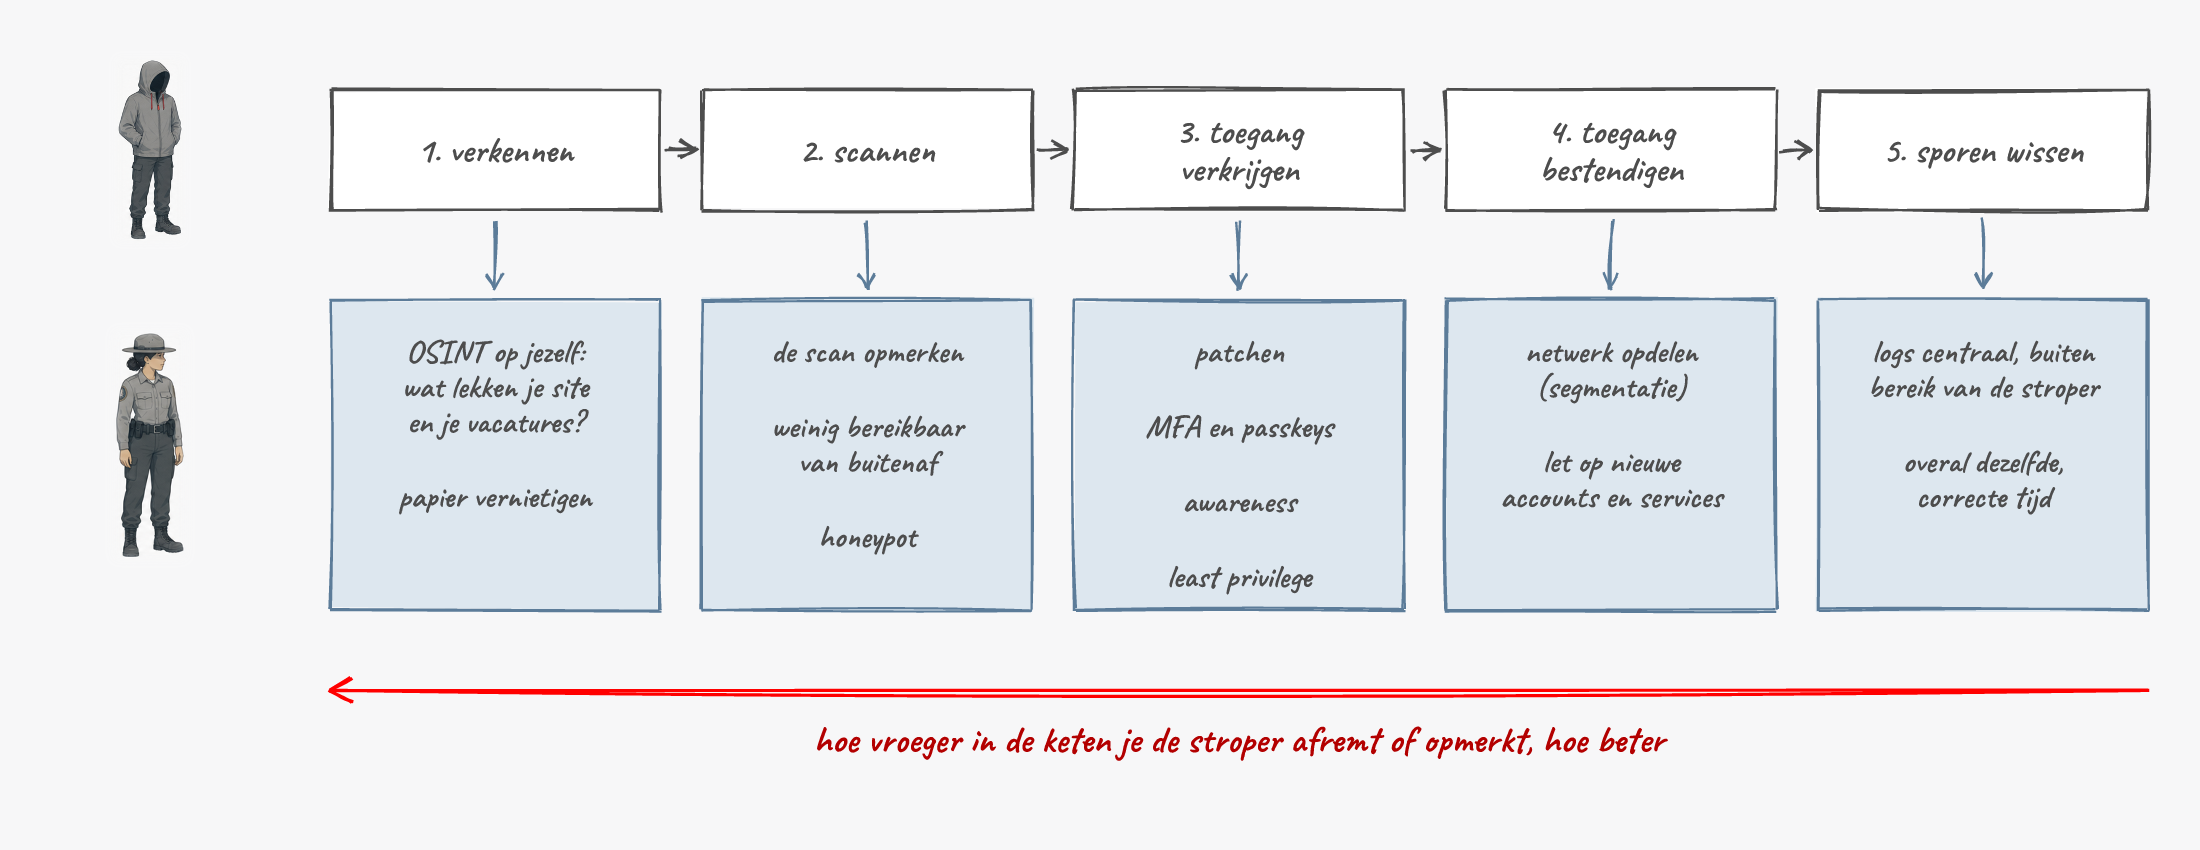
In Hoe vallen ze aan? zagen we dat quasi iedere aanval in vijf fasen verloopt: verkennen, scannen, toegang verkrijgen, toegang bestendigen en sporen wissen. Die lijst is niet enkel nuttig om de stropers te begrijpen, het is ook een handige kapstok voor de boswachter. In iedere fase kan je de stroper afremmen, opmerken of tegenhouden. En hoe vroeger in de keten, hoe beter.
Fase 1: verkennen
In deze fase kan je de stroper nauwelijks opmerken: hij leest je website, scrolt door de LinkedIn-profielen van je werknemers en rommelt misschien in je vuilbak. Wat je wel kan doen, is bepalen hoeveel er te vinden valt:
- Kijk eens zelf met de ogen van een stroper naar je organisatie. Welke informatie lekt je website, je vacatures (“ervaring met Citrix en Windows Server 2012 is een pluspunt”) of de sociale media van je personeel? De OSINT-technieken die aanvallers gebruiken, kan jij ook gebruiken.
- Maak werknemers bewust van wat ze online delen en vernietig papieren documenten in plaats van ze bij het oud papier te zetten (dumpster diving werkt nog steeds).
Fase 2: scannen
Scannen is de eerste fase waarin de stroper echt aan je deur morrelt, en dus de eerste fase waarin je hem kan zien. Een externe computer die op enkele minuten tijd honderden poorten afklopt, gedraagt zich niet als een normale bezoeker. Netwerkmonitoring en een intrusion detection system (IDS) kunnen daar alarm op slaan.
Nog beter is zorgen dat de scan weinig oplevert: hoe minder services er vanop het Internet bereikbaar zijn (simplicity!), hoe minder de stroper vindt. En scan vooral zelf, en liefst eerst. Wie geregeld zijn eigen netwerk met een vulnerability scanner doorlicht, of een red team inhuurt, vindt de gaten vóór de stroper ze vindt.
Een leuk verdedigingsmiddel in deze fase is een honeypot: een systeem dat er interessant uitziet, maar geen enkel echt doel heeft. Geen enkele legitieme gebruiker heeft er iets te zoeken, dus wie er toch aan komt, is per definitie verdacht.
Fase 3: toegang verkrijgen
Hier probeert de stroper effectief binnen te geraken, meestal via een ongepatchte kwetsbaarheid, een gestolen wachtwoord of een werknemer die op de verkeerde link klikt. De verdediging kennen we ondertussen:
- Patchen, zodat gekende kwetsbaarheden gedicht zijn.
- MFA en liefst passkeys, zodat een gestolen of geraden wachtwoord alleen niet volstaat.
- Awareness, zodat werknemers phishing en andere vormen van social engineering herkennen en vooral ook durven melden.
- Least privilege, zodat de stroper die tóch binnen is, met de rechten van een stagiair zit en niet met die van de CEO. Privilege escalation wordt zo een extra stap die hij moet zetten, en die je dus kan opmerken.
Fase 4: toegang bestendigen
Eens binnen, installeert de stroper backdoors, maakt hij nieuwe accounts aan en springt hij van systeem naar systeem (lateral movement). Twee dingen helpen hier:
- Het netwerk opdelen (segmentatie). Als de pc van de receptie niet rechtstreeks met de databaseserver kan praten, dan kan een stroper die op die pc zit dat ook niet. Een plat netwerk waarin alles alles kan bereiken, is voor de stroper een open vlakte. Hoe je dat concreet doet, zie je in Network Security.
- Opletten voor nieuwigheden. Een nieuwe beheerdersaccount die niemand aangevraagd heeft, een onbekende service die bij het opstarten mee opstart, een werkstation dat plots verbinding maakt met honderd andere werkstations: dit zijn sporen van een stroper die zich aan het nestelen is.
Fase 5: sporen wissen
Een slimme stroper past logs aan of wist ze (ook de gebroeders Akhter vroegen na hun sloopactie nog aan een AI-assistent hoe ze de systeemlogs konden wissen). Het antwoord is eenvoudig in principe: bewaar je logs centraal, op een plek waar de aanvaller niet bij kan. Iedere server stuurt zijn logs meteen door naar een aparte logserver met eigen accounts en eigen beheerders. De stroper die een webserver gepwnd heeft, kan de lokale logs op die webserver wissen, maar de kopie die al lang doorgestuurd werd, blijft staan. Nog beter is een opslag die enkel toevoegen toelaat en niets laat wijzigen of verwijderen (append-only of write once).
Zorg er ook voor dat alle systemen dezelfde, correcte tijd gebruiken. Wie na een incident de logs van tien systemen naast elkaar moet leggen om te reconstrueren wat er gebeurde, wordt niet blij van servers die elk een paar minuten anders lopen.
NIST Cybersecurity Framework 2.0: wie in een bedrijf over security-beleid praat, komt vroeg of laat het NIST CSF 2.0 tegen (februari 2024). Het deelt alle security-activiteiten van een organisatie op in zes functies: Govern (beleid en verantwoordelijkheden), Identify (weten wat je hebt en welke risico’s je loopt), Protect (beschermen), Detect (opmerken), Respond (reageren) en Recover (herstellen). Wat we in dit subhoofdstuk bespreken, valt daar mooi in: de principes en de maatregelen per fase zijn Protect, de volgende sectie is Detect, en de laatste sectie gaat over Respond en Recover.
Detecteren
Hoe goed je ook beschermt, je moet ervan uitgaan dat er ooit iemand binnen geraakt. Dat klinkt defaitistisch, maar het is gewoon de realiteit en de cijfers bevestigen het.
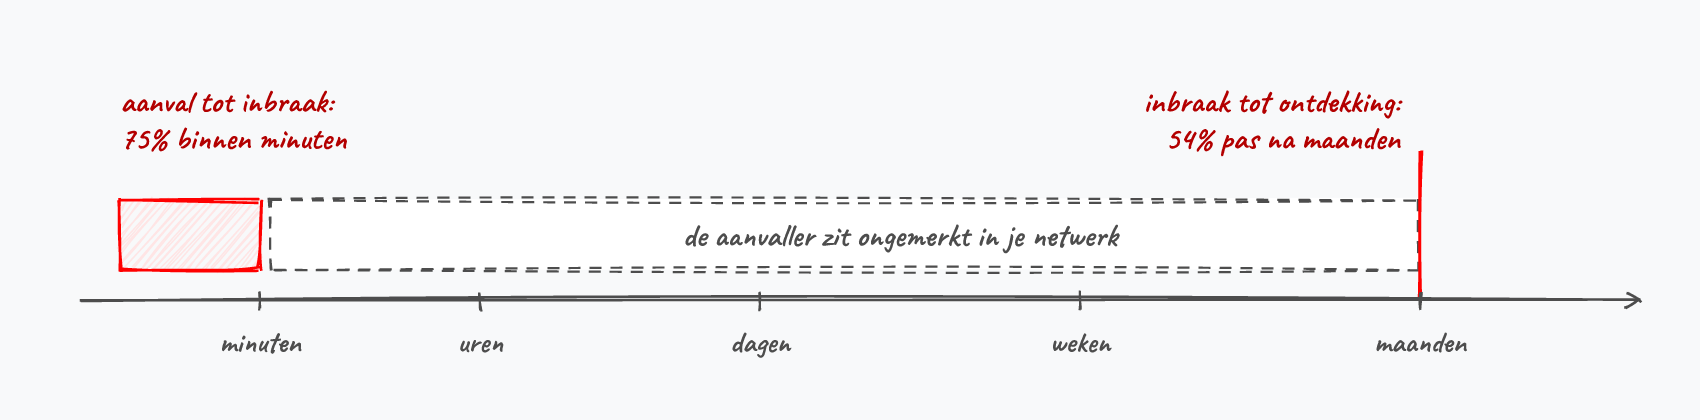
Dwell time - de stille meerderheid: cijfers uit de (ondertussen legendarische) Verizon Data Breach Investigations Report van 2012 (over inbraken in 2011) schetsen een ontluisterend beeld. Recentere edities tonen een gelijkaardig patroon. Aanvallers zijn razendsnel binnen, maar blijven vaak maandenlang onopgemerkt.
| Overgang | Sec. | Min. | Uren | Dagen | Weken | Maanden | Jaren |
|---|---|---|---|---|---|---|---|
| Aanval → inbraak | 10% | 75% | 12% | 2% | 0% | 1% | 0% |
| Inbraak → data stelen | 8% | 38% | 14% | 25% | 8% | 8% | 0% |
| Inbraak → ontdekking | 0% | 0% | 2% | 13% | 29% | 54% | 2% |
| Ontdekking → herstel | 0% | 1% | 9% | 32% | 38% | 17% | 4% |
De meest hallucinante regel is de derde: in meer dan de helft van de gevallen ontdekt een organisatie pas na maanden dat er iemand in haar netwerk zit.
Kortom: je detectiecapaciteit is minstens even kritisch als je preventie. Als je aanvaller maanden ongestoord rondwandelt, heeft hij alle tijd van de wereld om fase 4 (bestendigen) en fase 5 (sporen wissen) rustig uit te voeren. Investeer dus niet alleen in dikke muren, maar ook in alerte bewakers. Bron: Verizon DBIR.
Wie over detectie leest, struikelt al snel over drie afkortingen:
- SOC (Security Operations Center): het team (en vaak ook de letterlijke kamer met grote schermen) dat de beveiliging van een organisatie dag en nacht in de gaten houdt. Grote bedrijven hebben er een eigen, kleinere organisaties besteden dit vaak uit aan een externe partij.
- SIEM (Security Information and Event Management): de software waar al die centrale logs uit fase 5 in terechtkomen. Een SIEM verzamelt de logs van firewalls, servers, werkstations en applicaties, legt ze naast elkaar en slaat alarm wanneer een combinatie van gebeurtenissen verdacht is. Eén mislukte login is niets, vijfhonderd mislukte logins gevolgd door één geslaagde is een ander verhaal.
- EDR (Endpoint Detection and Response): de opvolger van de klassieke virusscanner. In plaats van enkel bestanden te vergelijken met een lijst van gekende malware, kijkt EDR naar het gedrag op een laptop of server (welk programma start welk ander programma, wie begint plots massaal bestanden te versleutelen, etc.) en kan het een toestel meteen van het netwerk isoleren.
De grootste vijand van een SOC is trouwens niet de stroper, maar de hoeveelheid alarmen. Een SIEM die per dag tienduizend meldingen genereert, waarvan 9.990 vals alarm, zorgt ervoor dat de analisten ook de tien echte meldingen wegklikken (alert fatigue). Net daarom wordt hier volop AI ingezet, zoals je kon lezen in AI als verdediger.
Hoe je zelf logs verzamelt, correleert en er detectieregels op schrijft, is materie voor Network Security.
Als het toch misgaat
Vroeg of laat gaat het mis. Het verschil tussen een vervelende week en een bedrijf dat over de kop gaat, zit dan vooral in wat je vooraf geregeld hebt.
Incident response
Een incident response-plan beschrijft wat er moet gebeuren wanneer er een beveiligingsincident is: wie beslist, wie belt wie, welke systemen gaan eerst offline, wie praat met de pers en de klanten. De bekendste referentie is NIST SP 800-61. In de vorige versie (revisie 2, 2012) beschreef NIST een cyclus in vier fasen:
- Voorbereiding (preparation): het plan, de contactlijsten, de tools en de back-ups klaarzetten vóór er iets gebeurt.
- Detectie en analyse: vaststellen dat er iets aan de hand is en inschatten hoe erg het is.
- Indammen, verwijderen en herstellen (containment, eradication and recovery): de schade beperken (bv. besmette toestellen van het netwerk halen), de stroper eruit zetten en de systemen terug opbouwen.
- Evaluatie achteraf (post-incident activity): wat liep er mis, wat hebben we geleerd, wat passen we aan in het plan?
In april 2025 verscheen revisie 3. Die laat de eigen cyclus los en hangt incident response op aan de zes functies van het NIST CSF 2.0 uit de vorige callout. De vier fasen verdwijnen daarmee niet, ze krijgen een plaats binnen die zes functies. In de appendix over awareness vind je een uitgebreidere versie van deze cyclus in zes stappen.
Eén praktisch detail dat vaak vergeten wordt: hoe communiceer je als je eigen systemen plat liggen? Als het incident response-plan enkel op de fileserver staat, en de fileserver is versleuteld, dan heb je geen plan. Hetzelfde voor de telefoonlijst in Outlook als de mailserver weg is.
Back-ups
We zeiden het al bij ransomware: back-ups zijn je laatste verdedigingslinie, maar enkel als de stroper er niet bij kan. De klassieke vuistregel is de 3-2-1-regel, bedacht door fotograaf Peter Krogh (bron):
- 3 kopieën van je data (het origineel en twee back-ups),
- op 2 verschillende soorten opslag,
- waarvan 1 kopie op een andere locatie.
Sinds ransomware ook actief op zoek gaat naar back-ups om die mee te versleutelen, voegt men daar vaak nog een extra regel aan toe: minstens één kopie staat offline (losgekoppeld van het netwerk) of kan niet gewijzigd worden (immutable). De afbeelding bij het LockBit-lek toont het principe.
En test je back-ups. Uit datzelfde LockBit-lek bleek dat slachtoffers vaak betaalden omdat hun back-ups onbruikbaar bleken op het moment dat ze die nodig hadden. Plan daarom geregeld een test waarbij je effectief een server of een map uit de back-up terugzet.
Maersk en de domeincontroller in Ghana: het verhaal van NotPetya bij rederij Maersk ken je al. Minder bekend is hoe het herstel verliep. Maersk moest op tien dagen tijd zo’n 4.000 servers, 45.000 pc’s en 2.500 applicaties opnieuw installeren. Het grootste probleem waren de domeincontrollers: de servers die weten welke gebruikers en computers er in het bedrijf bestaan en wie wat mag. Maersk had er een 150-tal, verspreid over de wereld en netjes met elkaar gesynchroniseerd, zodat iedere domeincontroller als reservekopie van de andere kon dienen. Alleen had niemand rekening gehouden met het scenario waarin ze allemaal tegelijk gewist werden, en dat is exact wat NotPetya deed.
Allemaal, op één na. Een domeincontroller in Ghana was net door een stroompanne offline toen de aanval toesloeg, en bleef daardoor gespaard. De internetverbinding in Ghana was te traag om de honderden gigabytes door te sturen, dus werd de schijf fysiek overgebracht: een medewerker uit Ghana vloog naar Nigeria, waar hij iemand van Maersk uit het Verenigd Koninkrijk ontmoette die de kostbare vracht naar het hoofdkwartier van het herstelteam bracht. De totale kost van de aanval voor Maersk werd geschat op 250 à 300 miljoen dollar.
Een bewuste offline kopie had Maersk niet: de kopie in Ghana was offline door een stroompanne. Bronnen: Wired, “The Untold Story of NotPetya”, BleepingComputer.
Oefenen: de tabletop
De goedkoopste manier om een incident response-plan te testen is een tabletop-oefening: de betrokkenen (IT, directie, communicatie, juridische dienst, …) zetten zich rond de tafel en een begeleider speelt een scenario uit. “Het is maandagochtend, 7u30. De eerste werknemers melden dat hun scherm een losgeldbericht toont. Wat doen jullie?” Stap voor stap komen er nieuwe elementen bij: de pers belt, een klant meldt dat zijn data online staat, de back-up blijkt drie weken oud.
Er wordt geen enkele computer aangeraakt. Toch komen er telkens verrassend concrete gaten boven: niemand weet wie mag beslissen om het netwerk plat te leggen, het telefoonnummer van de verzekeraar staat enkel in een mailbox die niet meer bereikbaar is, de back-upverantwoordelijke is net met vakantie.
Hulp in België
Je staat er als Belgische organisatie niet alleen voor. Het Centrum voor Cybersecurity België (CCB) is de nationale autoriteit voor cyberveiligheid. Binnen het CCB zit CERT.be, het team dat incidenten opvolgt en organisaties helpt wanneer het misloopt. Bedrijven en organisaties kunnen een incident melden via notif.safeonweb.be.
Safeonweb is het publieke gezicht van het CCB. Voor burgers is er safeonweb.be met sensibiliseringscampagnes en het adres suspicious@safeonweb.be, waar je verdachte berichten naar kan doorsturen. Voor organisaties is er Safeonweb@work met adviezen en tools.
Voor sommige organisaties is melden trouwens geen vrije keuze maar een wettelijke verplichting. Daarover meer in het deel over regelgeving.
Samenvatting
In dit hoofdstuk legden we de fundamenten vast waarop de rest van dit boek verder bouwt:
- CIA (confidentiality, integrity, availability) is het doel; de McCumber kubus dwingt je om dat doel te bewaken op élke datastatus (opslag, verzenden, verwerking) én op élke laag (technologie, beleid, mensen).
- De wapenwedloop is scheef: aanvallers hebben snelheid, schaal en eenvoudig te gebruiken tools, terwijl verdedigers aan álles moeten denken.
- Zero days en het window of vulnerability maken patchen tot een permanente discipline - Patch Tuesday impliceert Exploit Wednesday.
- De aanvallers zijn divers: van scriptkiddies over eigen werknemers tot cybercriminelen en door overheden gesponsorde actoren. Ieder profiel vraagt een eigen verdediging.
- Aanvallen verlopen in vijf fasen (verkennen, scannen, toegang verkrijgen, bestendigen, sporen wissen) en zijn passief (sniffing, trafiekanalyse) of actief (masquerading, replay, MitM, DoS); de meeste starten met social engineering.
- Malware-families (virus, worm, trojan, rootkit, ransomware, botnet), side-channels (Spectre, Whisper Leak) én verwante creatieve aanvallen (Rowhammer, KNOB) tonen dat elke laag (software, hardware én menselijk gedrag) een aanvalsoppervlak is.
- Verdedigen steunt op defense in depth, least privilege, diversiteit en een zo klein mogelijk aanvalsoppervlak (hardening, secure baseline, geen configuration drift).
- In elke fase van een aanval kan de boswachter iets doen, van minder prijsgeven bij het verkennen tot centrale logs die de stroper niet kan wissen.
- Detectie is even belangrijk als preventie: een SOC, SIEM en EDR moeten de dwell time van maanden terugbrengen.
- Als het toch misgaat, maken een geoefend incident response-plan en offline back-ups het verschil. In België kan je terecht bij het CCB.
Onthoud vooral: de zwakste schakel is zelden technisch.